高通副总裁详解HBC技术优势与2bit量化进展,分析其相比HBM在带宽、功耗及成本上的显著优势,并探讨端云协同智能体落地路径,适合关注AI芯片与推理优化的技术人员阅读。
在AI大模型推理中,内存带宽往往成为性能瓶颈。高通近期提出的高带宽计算(HBC)技术,通过将计算移至数据附近,宣称可实现比HBM更优的性价比和带宽效率。本文将结合高通副总裁侯纪磊的最新分享,深入解析HBC的技术原理、量化挑战及端云协同策略。
一、2bit量化技术前沿进展
在深入探讨HBC架构之前,不得不先解决AI推理落地中绕不开的“精度”难题。高通在极低比特量化领域已处于行业前沿,特别是在4bit转2bit的量化感知训练(QAT)方案上,不仅技术成熟,还已与部分中国厂商展开合作,提供成熟的参考方案。
从基准测试数据来看,高通的2bit参考方案在性能表现上非常接近传统的16bit/32bit浮点(FP)模型。这听起来似乎违背直觉,因为比特位数的断崖式下降通常意味着精度的剧烈损失。然而,2bit量化的核心挑战并不在于单纯的数值截断,而在于模型系统容量的破坏以及多任务泛化能力的受限。如果仅靠算法强行压缩,模型很容易在复杂场景下“崩盘”。
解决这一瓶颈的关键,在于QAT过程中的数据匹配。必须使用多元化、具备鲁棒性的实际用例数据进行训练,才能让模型在极端低比特下保持稳定的推理能力。以谷歌Gemma 4系列E2B/E4B模型为例,其提供的2bit QAT检查点就充分证明了,只要数据分布覆盖得当,超低比特模型依然能维持可用的精度水平。这对于后续讨论HBC如何在端侧高效运行这些轻量级模型至关重要。
二、HBC技术原理与优势分析
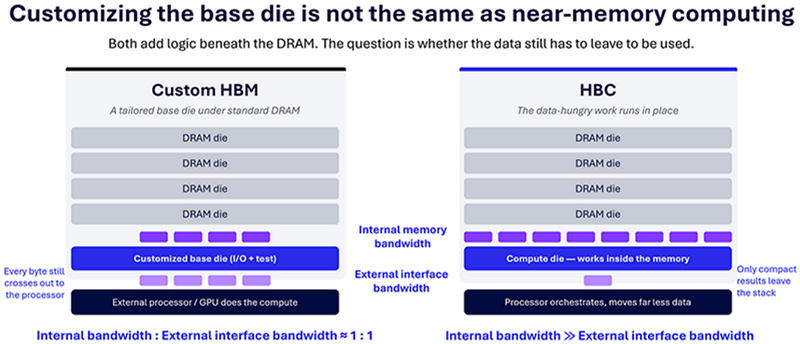
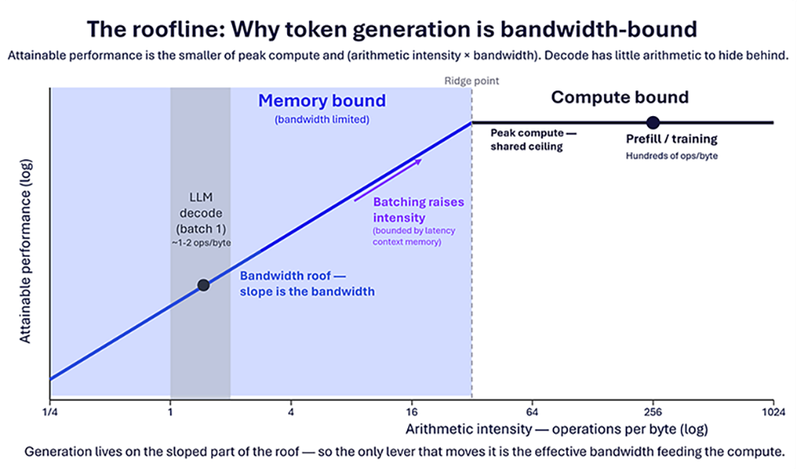
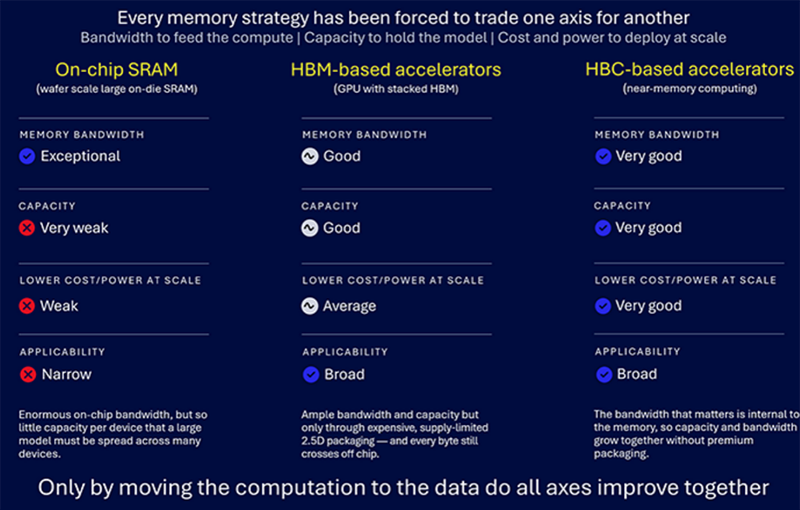
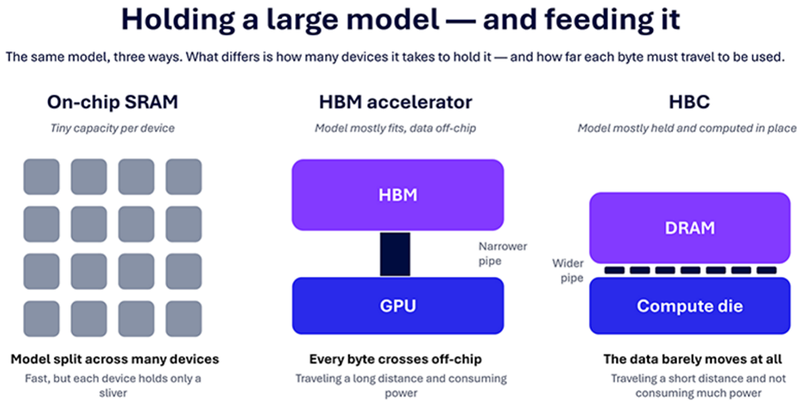
解决了量化带来的精度挑战,我们自然要回到支撑这些轻量级模型高效运行的底层架构。高通提出的HBC(High Bandwidth Computing)技术,其核心逻辑在于打破传统冯·诺依曼架构中数据与计算分离的瓶颈,采用3D堆叠近存计算架构。这种设计将数字逻辑芯片直接放置在内存架构的底层,让计算单元贴近数据存储位置,从而大幅减少数据在存储与处理单元之间的长距离移动。
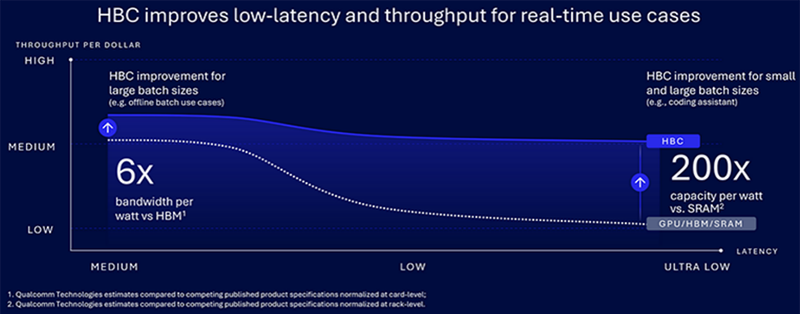
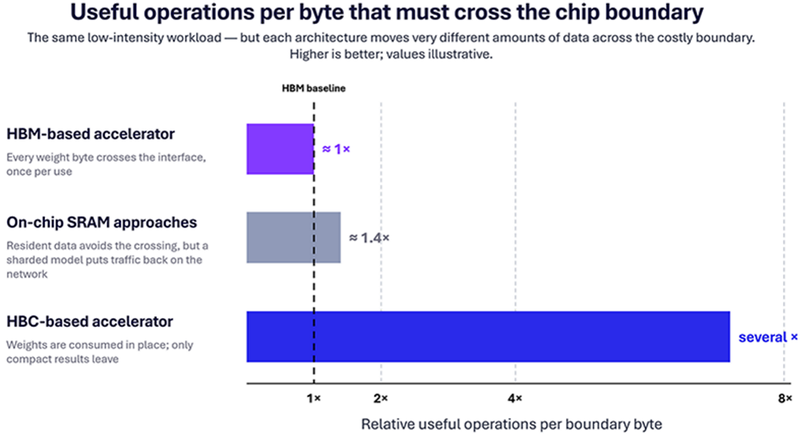
这种架构调整带来了显著的性能跃升。以高通飞龙系列为例,搭载HBC一代的AI250芯片,其有效内存带宽较前代AI200提升了18倍;而最新的HBC二代(AI300)更是将这一倍数推高至54倍。在能效比方面,HBC的优势同样突出:相比HBM,HBC拥有6倍的每瓦特带宽优势;相比片上SRAM,则具备200倍的每瓦特容量优势。相比之下,传统方案中SRAM成本高且容量受限,HBM虽带宽大但功耗较高,HBC则在成本、功耗与带宽之间找到了更优的平衡点,为端侧AI推理提供了极具性价比的硬件基础。
三、端云协同与智能体落地策略
硬件底座的夯实只是第一步,真正决定AI体验上限的,是端云如何协同作战。侯纪磊强调,端侧与云端的分工并非割裂,而是基于任务特性的互补:端侧天然适合处理简单、隐私敏感及个人化的任务,而云端则更擅长应对复杂长上下文、强推理逻辑及智能体编排等高负载场景。这种分工使得高通可以将端侧验证成熟的低比特量化、多token生成及近存计算等技术,平滑迁移至云侧架构,实现技术资产的复用与效率最大化。
在落地策略上,高通选择与两家头部模型厂商进行深度适配,而非单纯提供芯片。这种合作模式旨在形成一套成熟的参考方案,直接赋能OEM客户,显著降低其开发成本与集成难度。根据预测,随着架构优化,端侧智能密度预计每12个月提升2-4倍,这将直接推动10B至20B级别模型在终端设备上的流畅运行。此外,隐私保护机制也被置于核心位置,通过建立端侧私密处理环境并定义清晰的接口“握手”协议,确保数据在本地闭环处理,从底层架构上筑牢安全防线。