本文详解Meta推出的Muse Voice Transcribe实时语音转写模型,解析其自适应延迟、多说话人分割及多语言切换能力,适合关注AI语音识别技术的开发者与产品经理阅读。
Meta最新发布的Muse Voice Transcribe模型,打破了传统语音转写在长音频和多人对话场景下的局限。它不仅实现了中英文无缝切换,更通过自适应延迟技术在速度与准确率之间找到了最佳平衡,标志着语音识别技术向实时感知层的重要演进。
一、模型核心能力与性能表现
Muse Voice Transcribe 在基础能力上展现了极高的工程化成熟度,直接切中了长音频处理这一痛点。传统 ASR 模型往往在处理超过半小时的录音时面临内存溢出或精度下降的问题,而该模型原生支持超过 1 小时的连续音频输入,无需人工切片或复杂的后处理拼接,大幅降低了开发者的集成成本。
- 多说话人支持:模型能够稳定处理超过 20 位说话人同时存在的场景,并自动完成语音分割,这对会议记录、播客制作等高频场景至关重要。
- 多语言覆盖:基于 70 多种语言数据训练,其中 25 种核心语言经过全面验证,为全球化应用提供了坚实基础。
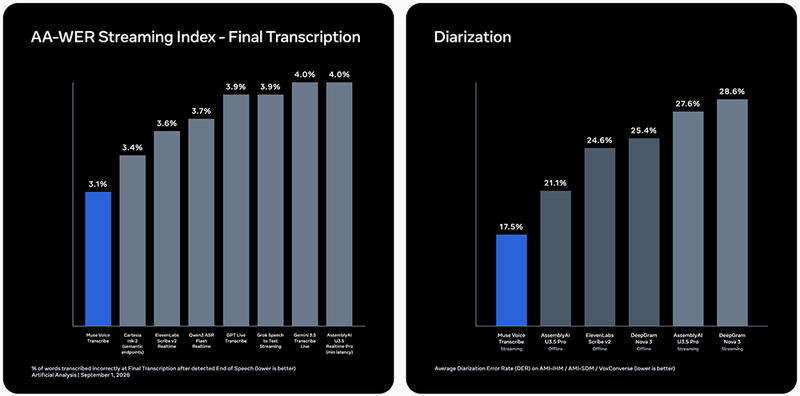
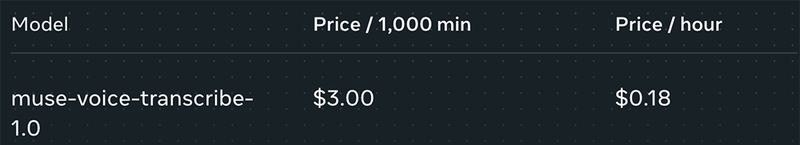
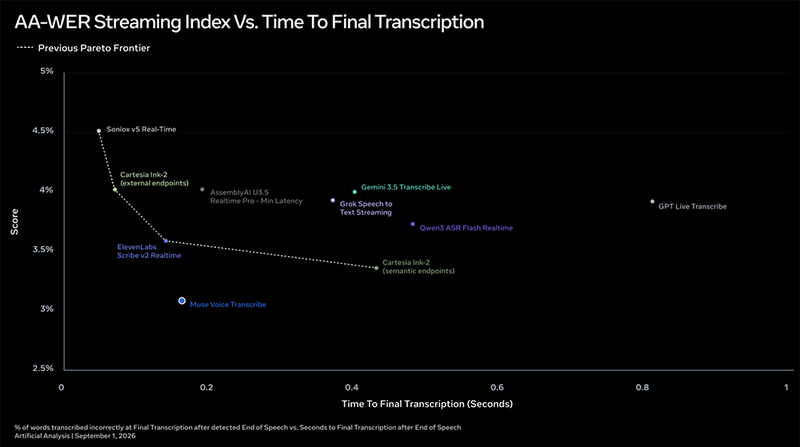
性能方面,在 Artificial Analysis 发布的流式语音转文本及公开语音分割基准测试中,Muse Voice Transcribe 均位列第一,验证了其在行业内的领先地位。对于预算敏感的项目,其 API 定价极具竞争力:每 1000 分钟仅需 3 美元(约合人民币 20 元),折合每小时成本仅为 0.18 美元,使得大规模部署成为可能。
二、多语言切换与语码识别机制
在处理完基础性能后,更令人关注的是模型在真实交流中的灵活性,尤其是多语言混合场景。Muse Voice Transcribe 原生支持任意语码转换(Code-Switching),无论是句子内部的即时切换,还是句子之间的自然过渡,都能实现无缝处理。这种能力对于处理中文、中式英语口音以及典型的中英文混合表达(Chinglish)尤为关键,避免了传统 ASR 在语言边界处出现的断句错误或识别卡顿。
其核心机制在于利用上下文信息来动态调整识别策略。当检测到用户随意切换中英文时,模型并非简单地进行语言判定,而是结合前后文的语义关联,确保转写结果既快速又准确。例如,在“这个 feature 的 latency 有点高”这样的混合表达中,系统能精准区分英文术语与中文语法结构,无需人工干预即可输出流畅文本。这对于跨国团队协作、播客访谈等高频使用混合语言的场景极具实用价值,显著提升了非标准语言环境下的识别鲁棒性。
三、流式ASR架构与自适应延迟
多语言识别解决了“说什么”的问题,而流式架构则决定了“多快能听到”。在底层实现上,Muse Voice Transcribe 采用了一种基于 80ms 时间步长的流式处理机制。音频流被切分为 12.5Hz 的片段,每个片段在内部转换为一个软 token。这一颗粒度的选择旨在平衡计算负载与响应实时性,确保模型能在毫秒级窗口内做出决策。
该架构的核心在于模型拥有“主动控制权”。在处理每个音频片段时,模型并非机械地逐字输出,而是通过强化学习(RL)动态决定下一步动作:是预测 <|next_audio|> 继续监听,还是输出文本 token。这种自适应延迟机制通过优化 WER 奖励与延迟奖励的平衡,让模型在不确定时选择等待更多上下文,在确定时立即输出,从而在转写速度和准确率之间达到了帕累托前沿。当音频流停止时,系统插入 <|empty_audio|> 信号,触发模型立即冲刷缓冲区,输出所有剩余文本,确保长对话末尾不丢失内容。这种设计不仅提升了实时感,也为后续的多说话人端点检测奠定了低延迟基础。
四、说话人分割与端点检测实现
低延迟架构解决了时序问题,但多人对话场景还面临另一个挑战:谁在说话?传统方案往往需要将ASR与独立的说话人分离模块串联,导致链路延迟叠加。Muse Voice Transcribe 通过将这一能力内嵌至流式ASR架构中,实现了更高效的协同。模型引入了特定的控制token,使得转写流能够同时承载文本内容与说话人身份信息,无需额外的后处理环节即可输出结构化的多说话人数据。
在实现机制上,当检测到说话人意图切换时,模型会立即输出 <|start_of_turn|> 信号,这保证了端点检测的实时性。然而,为了保持识别的稳定性,具体的说话人标签 <|speaker_{A-Z}|> 并不会立即生成,而是延迟至当前音频块末尾进行预测。这种“信号即时、标签延后”的设计,有效避免了在语音起始阶段因上下文不足导致的身份误判。与此同时,模型利用 <|speech_onset|> 和 <|speech_endpoint|> 精确标记语音活动的起止,构建了完整的语音活动检测(VAD)闭环。例如,在识别到“Hey Meta”这一短语时,输出序列会清晰呈现为 <|speech_onset|>Hey Meta...<|speech_endpoint|>,并伴随相应的说话人标识,为下游应用提供了高保真的对话结构信息。