本文详解李飞飞团队发布的世界模型Atlas,涵盖摄像机控制、空间重建及时空模拟功能,帮助开发者了解其在3D生成与机器人仿真中的应用。
“AI教母”李飞飞创办的World Labs发布了新一代世界模型Atlas。该模型不仅能生成逼真的视频和图像,还实现了突破性的三维空间重建和“子弹时间”式的时间维度控制。本文将带你深入解析Atlas的核心能力与技术架构。
一、Atlas核心能力与架构概述
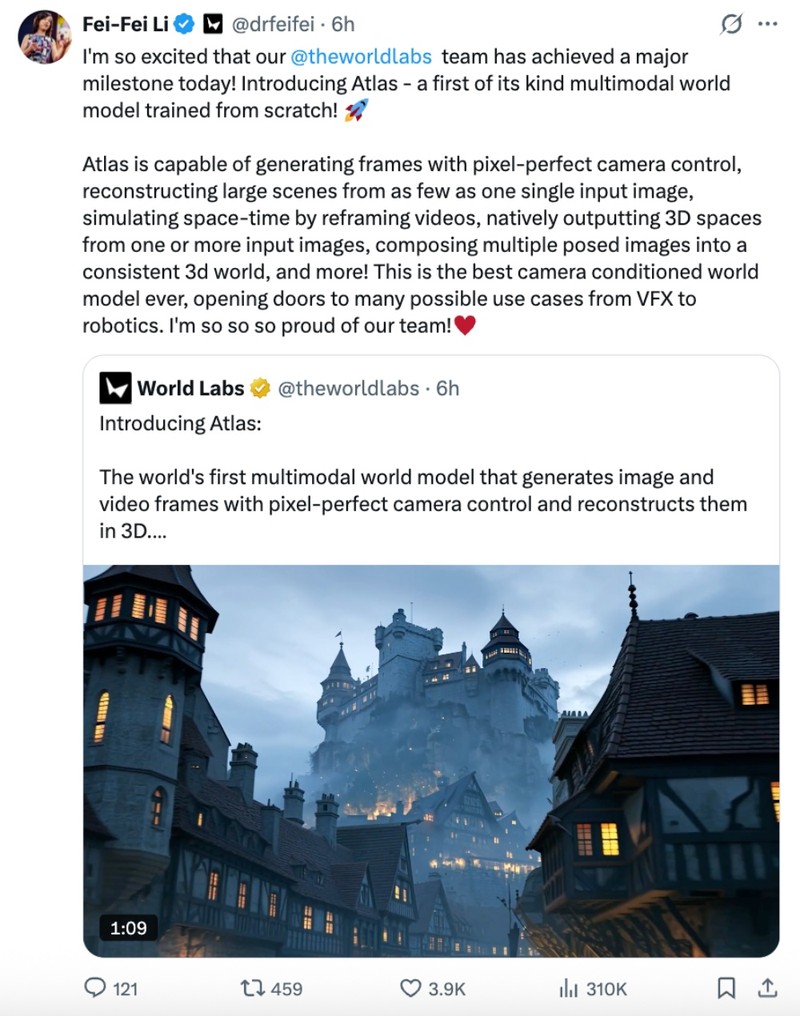
Atlas并非传统意义上的视频生成器,而是一个基于多模态自回归扩散Transformer架构的世界模型。其核心逻辑在于将文本、图像、视频等多源输入融合至共享的空间上下文,从而实现对物理世界的生成、重建与模拟。这种架构设计使得Atlas在理解三维空间关系上具备显著优势,而非仅仅停留在二维像素的堆叠。
- 摄像机控制生成:支持像素级视角控制,可输出1440p分辨率且长达一分钟的高保真视频,极大提升了内容创作的自由度。
- 空间重建:仅需1至数十张静态图像,即可重建真实世界的三维场景,性能超越专用3D重建模型,解决了稀疏视角下的重建难题。
- 时空模拟:能够对视频进行动态重新构图,这一特性直接打通了机器人“真实到模拟”(Real-to-Sim)的工作流程,为仿真训练提供高保真环境。
- 图像生成:支持根据文本生成高质量图像及360°全景图,拓展了空间内容的呈现维度。
注意:Atlas的“时空模拟”能力意味着它不仅能“看”到空间,还能“推演”时间的变化,这是其区别于普通生成模型的关键所在。后续章节将深入探讨其具体应用场景。
二、摄像机控制与360°全景生成
上一章提到Atlas具备摄像机控制能力,具体而言,这意味着用户不再受限于固定视角。通过输入单张或多张参考图像,Atlas能够基于空间上下文,在任意摄像机位置和角度生成新画面,且新生成的画面与原始输入的几何结构严格匹配。这种能力不仅仅是视角的旋转,更是一种空间上的逻辑推演:系统能将参考图像锚定在三维坐标中,即使在参考视角之间存在较大盲区,也能平滑过渡并补全未见场景,确保视觉上的连贯性。
- 长视频连贯性:结合精细的摄像机运动路径规划与空间锚定技术,Atlas能够输出1440p分辨率、时长达一分钟的高保真视频,有效解决了传统生成模型在长时序下容易出现的几何漂移问题。
- 全景图生成:除了动态视频,Atlas还支持根据文本或图像直接生成360°全景图。其优势在于能保持全景范围内视觉风格和内容逻辑的高度统一,适用于虚拟现实场景构建或沉浸式内容创作,为后续的空间交互提供了完整的视觉基础。
三、稀疏图像三维空间重建
如果说摄像机控制解决了“看哪里”的问题,那么三维空间重建则解决了“场景是什么”的核心难题。Atlas在处理新视角合成时,不再依赖密集的图像输入,而是能通过稀疏的几张照片,逻辑地推断出不可见区域的几何结构,实现真正的空间补全。这种能力让静态图像瞬间拥有了深度的维度感。
- 实例演示:在实际测试中,Atlas展示了惊人的空间推理能力。仅凭一张地面照片,系统便能推演并生成该位置的鸟瞰图;更令人印象深刻的是,利用25张地面图像,Atlas成功重建了斯坦福大学主方庭的场景,并生成了平滑的俯瞰飞行路径视频,画面细节与地面视角保持高度一致。
- 多轨迹生成:针对同一重建场景,用户可以随意定义多条不同的摄像机运动轨迹。无论路径如何变化,Atlas都能确保场景内容的连贯性与一致性,避免了传统拼接方法中常见的物体形变或光影断裂。
- 3D原生输出:除了视频渲染,Atlas原生支持将重建结果输出为点云或3D高斯泼溅格式。它不仅填补了点云数据中的空缺区域,还能进行高分辨率渲染,为后续的空间交互或机器人仿真提供了高精度的几何底座。
四、时空模拟与机器人仿真应用
如果说空间重建赋予了场景以“体”,那么时间维度的介入则让场景拥有了“生命”。Atlas不仅是一个静态的3D生成器,更是一个能够模拟物理交互的世界模拟器。其核心亮点在于实现了类似电影特效的“子弹时间”功能。在实际操作中,用户只需使用三台摄像机同步录制一段视频,Atlas便能解析出物体在时间轴上的连续运动轨迹。此时,用户可以在时间轴上任意暂停,并自由调整摄像机角度,生成从侧面、背面甚至空中俯瞰的平滑过渡画面。这种能力打破了传统视频编辑中“所见即所得”的限制,让镜头语言拥有了前所未有的自由度。
在更具实用价值的机器人领域,Atlas展现出作为仿真引擎的巨大潜力。它能模拟机器人在复杂空间中的导航过程,并同步生成传感器视角下的RGB图像与深度数据。对于开发者而言,这意味着无需昂贵的实体硬件,仅通过随意录制的视频,即可构建包含物体运动与交互细节的高保真仿真环境。更关键的是,Atlas支持对仿真环境进行变量调整,例如替换特定物体、调整光照条件或改变动作参数。这种灵活性为机器人算法的规模化训练提供了海量多样化的测试数据,极大地降低了真机实验的成本与风险。
五、技术架构对比与性能优势
上述应用能力的背后,是Atlas在技术架构上的深度融合。它并未简单堆砌组件,而是构建了一个统一架构,将多模态处理、自回归生成、扩散模型与Transformer骨干网络有机结合。这种设计使其能够原生支持文本、图像、相机位姿及3D深度图等多种输入模态,实现了从语义理解到像素生成的无缝衔接。
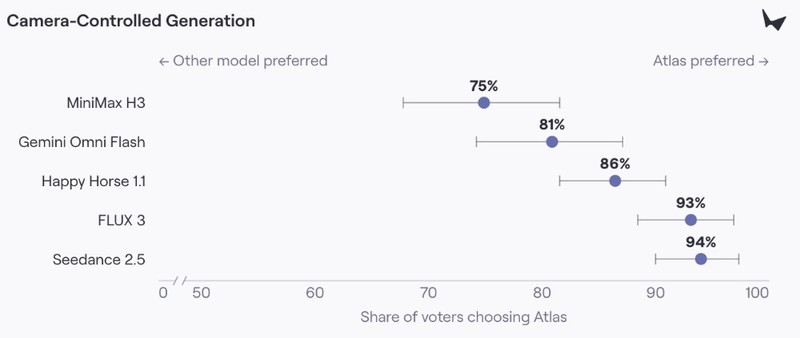
在推理效率上,Atlas借鉴了大语言模型(LLM)的加速经验,应用了KV cache等关键技术,并采纳了扩散蒸馏、无分类器引导等视频生成算法,显著提升了生成速度。相比之下,传统模型往往依赖文本描述来间接控制镜头,存在语义歧义。而Atlas通过原生编码相机参数,在摄像机指令遵循度上表现出明显优势,能够精准执行复杂的运镜需求。
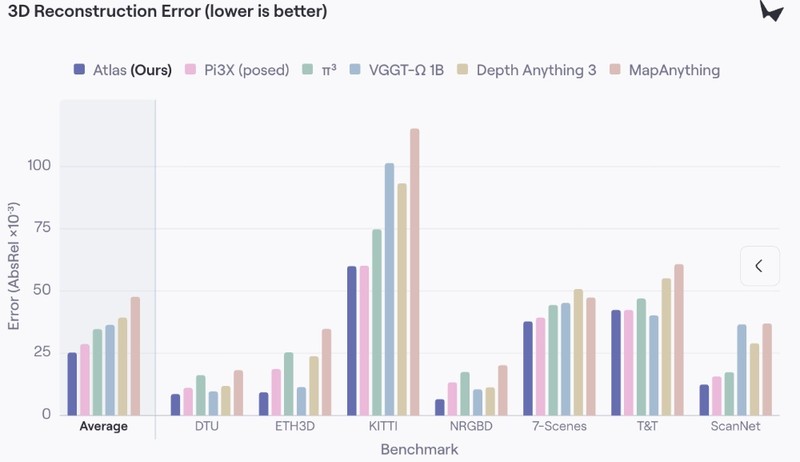
此外,在三维重建的基准测试中,Atlas面对稀疏输入数据时,其重建精度也优于当前最佳的专用开源重建模型。这意味着开发者在数据受限的场景下,依然能获得高质量的3D场景还原。这种架构上的优势,不仅降低了技术门槛,也为后续更复杂的交互式生成奠定了坚实基础。