Penguin 推出业界首款 CXL 量产型 KV Cache 服务器,融合 3TB DDR5 与 8TB CXL 内存,旨在降低 AI 推理延迟并提升吞吐量。
AI 推理场景对内存的需求远超算力,Penguin 最新发布的 MemoryAI KV Cache 服务器正是为此而生。通过整合 3TB 主内存与 8TB CXL 扩展模块,它打破了传统内存瓶颈,为高延迟敏感型任务提供了新的基础设施选择。
一、Penguin 推出首款 CXL KV Cache 服务器
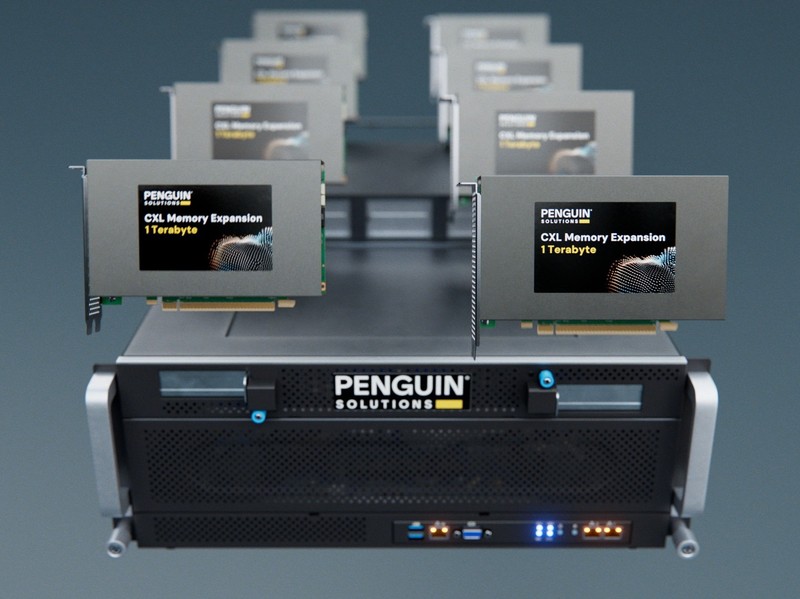
2026 年 3 月 16 日,Penguin Solutions 正式发布了其最新硬件产品 MemoryAI KV Cache 服务器。这款产品的问世,标志着业界首款采用 CXL 技术的量产型 KV Cache 服务器正式落地,填补了该细分领域在标准化量产设备上的空白。
在硬件架构上,该服务器采用了混合内存设计。其核心配置包含 3TB 的 DDR5 系统主内存,用于满足高频次、低延迟的即时数据访问需求。在此基础上,系统进一步集成了 8 个 1TB 的 CXL 内存 AIC 模块,通过 CXL 互联技术将主内存与扩展内存无缝连接。这种组合使得服务器的总可用内存容量达到了惊人的 11TB,为大规模 AI 推理任务提供了充裕的缓存空间。这一硬件规格的确立,不仅展示了 Penguin 在内存互联技术上的工程能力,也为后续深入探讨 AI 推理对内存依赖性的解决思路奠定了坚实的硬件基础。
二、解析 AI 推理的内存依赖性
硬件规格的提升背后,是 AI 推理场景对底层资源需求的深刻重构。Penguin 在发布此次新品时提出了一个颇具冲击力的观点:在典型的 AI 推理任务中,性能瓶颈往往不在算力,而在于内存——通常而言,30% 依赖于算力而 70% 依赖于内存。这与大家熟知的模型训练或微调阶段形成鲜明对比。在训练阶段,GPU 算力是绝对的主导,因为大量的矩阵运算需要极高的浮点性能来支撑。然而,一旦进入推理阶段,尤其是处理长上下文或复杂逻辑时,负载的特性发生了根本性变化,内存容量与带宽成为了决定吞吐量的关键因素。
这种差异主要源于 KV Cache 的机制。随着对话轮次增加或上下文窗口扩大,缓存键值对(Key-Value Pairs)会迅速占据大量显存或内存空间。如果内存不足,系统不得不进行频繁的交换(Swapping)或重新计算,这将导致严重的性能抖动。对于终端用户而言,这种底层资源的争用直接反映为响应延迟的增加。在实时交互应用中,哪怕几百毫秒的额外延迟,都会显著降低使用体验的流畅度,甚至导致用户流失。因此,构建一个大容量、低延迟的内存层级,不再仅仅是性能优化的选项,而是保障 AI 服务可用性和体验的基础设施前提。这也解释了为何 MemoryAI 服务器要特意引入 CXL 技术来扩展内存池,以从容应对这种内存密集型挑战。
三、MemoryAI 服务器核心优势与应用场景
承接上文关于内存瓶颈的分析,MemoryAI 服务器通过将 3TB DDR5 与 8TB CXL 深度融合,直接转化为可量化的性能红利。这种架构不仅显著降低了推理延迟,更关键的是大幅缩短了首 Token 响应时间(Time to First Token)。对于依赖即时反馈的交互式应用而言,这意味着用户感知到的“等待感”被压缩至最低,整体吞吐量随之提升。
在效率层面,该设计极大地提高了 XPU 集群的利用效率。由于内存不再是短板,计算单元无需频繁因数据换入换出而空转,从而在相同硬件投入下实现了更高的服务密度。这种稳定性使其能够持续满足严苛的服务水平一致性(SLO)要求,确保在高并发负载下性能指标不波动。
基于此,该服务器特别适用于对窗口大小和延迟极度敏感的企业级任务。例如,实时金融分析 需要毫秒级处理海量交易数据;海量数据集 RAG 检索要求快速定位长文档中的关键信息;以及 监管合规性分析 需对复杂文档进行低延迟的结构化解析。这些场景共同特征明确:需求大上下文窗口且对延迟零容忍。MemoryAI 正是为此类高价值、高要求业务提供了坚实的基础设施支撑。