本文分享使用腾讯WorkBuddy搭建Data+AI全球日报的完整实战,涵盖Prompt配置、企微推送及GitHub部署,帮助技术团队实现低成本AI情报自动化。
在AI Agent兴起的当下,如何低成本搭建高效的情报收集系统?本文以腾讯WorkBuddy为例,展示如何通过一份3000字的“情报宪法”和两个Python脚本,实现每日自动推送的高质量行业日报。
一、日报成果展示与推送机制
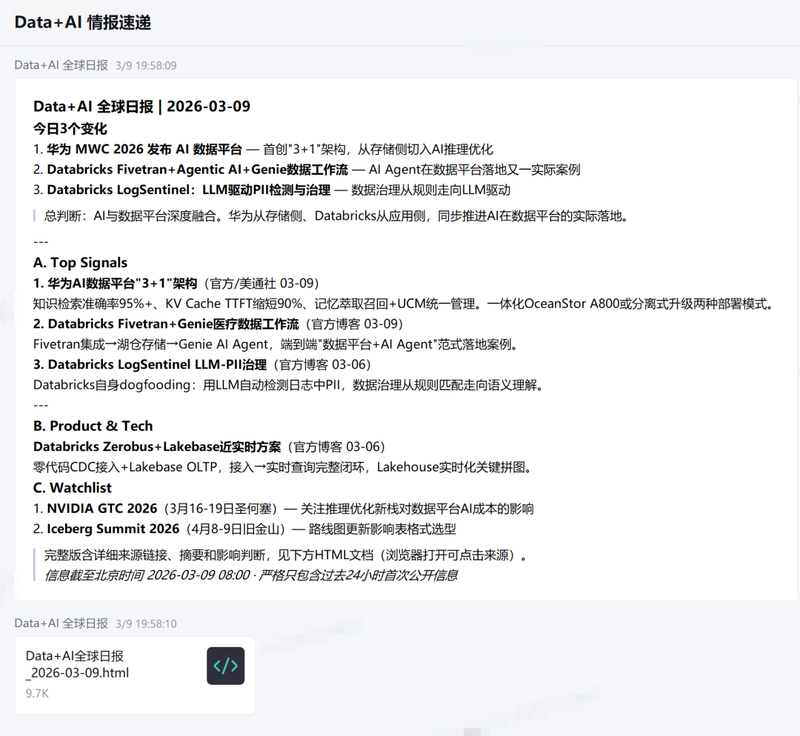
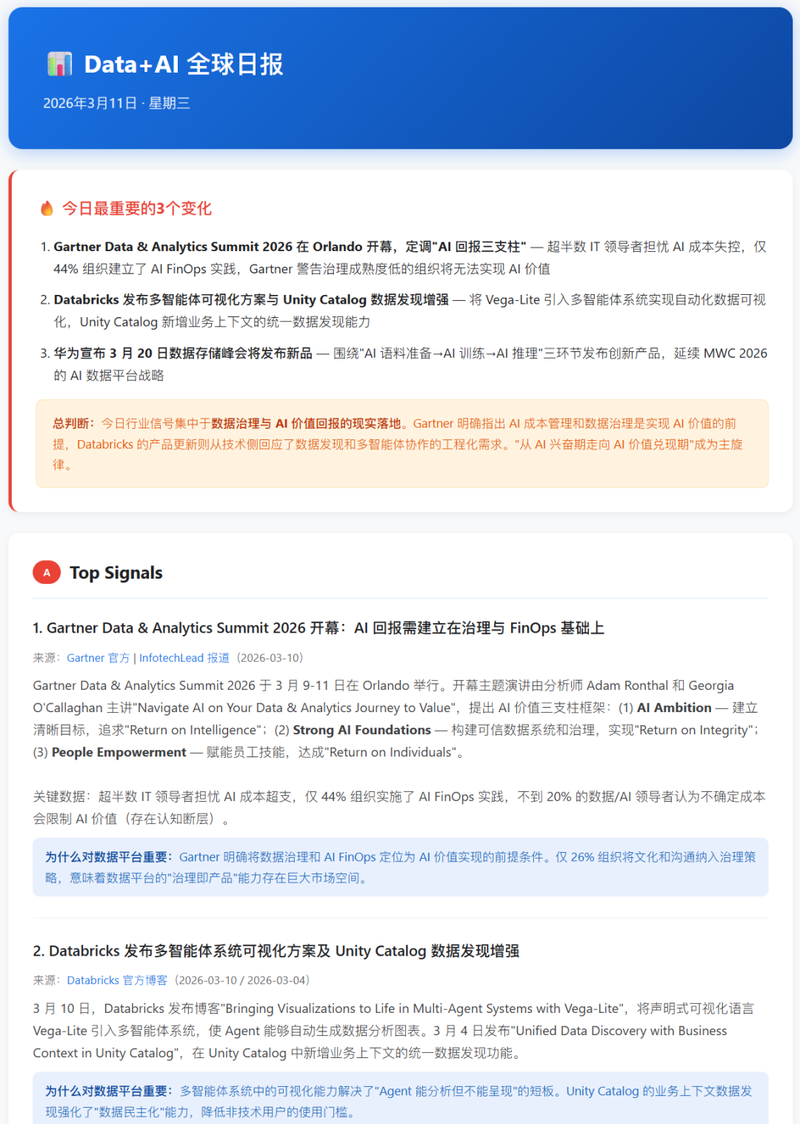
在深入探讨技术实现之前,先看一眼最终跑通的效果。目前这套《Data+AI全球日报》已经稳定运行,形成了“即时摘要+深度阅读”的双层分发模式。每天定时触发后,系统会先向企业微信群推送一份Markdown精简版摘要,方便大家在通勤或碎片时间快速浏览核心要点;随后,完整的HTML版本会同步发布至GitHub Pages,地址为 https://haiyangchenbj.github.io/data-ai-daily/。这种设计既保证了内部沟通的即时性,又为需要深度研究的内容提供了持久的公开入口。
日报的内容结构经过精心打磨,旨在平衡信息密度与可读性。每期精选8-12条高价值情报,并严格划分为5个固定板块,包括Top Signals(顶级信号)、Product & Tech(产品与技术)、以及市场动态等。这种分类逻辑不仅有助于快速定位感兴趣的领域,也确保了情报的垂直度。对于技术团队而言,这种标准化的输出格式极大降低了筛选噪音的成本,让每天早晨的第一杯咖啡时间变得高效且充实。
提示:在配置推送策略时,建议将Markdown摘要控制在手机屏幕一屏之内,避免折叠,这样才能最大化阅读效率。关于如何具体设计这份“情报宪法”,我们将在后续章节中详细展开。
二、WorkBuddy选型优势分析
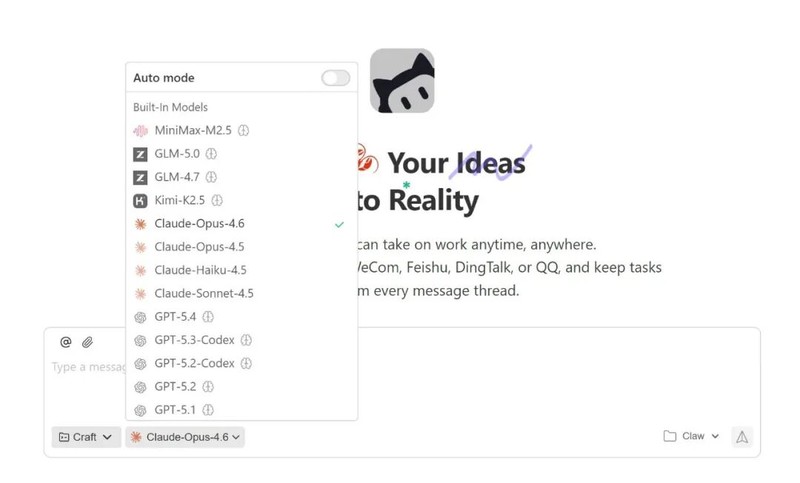
既然效果已经呈现,很多技术同行可能会问:市面上开源Agent工具那么多,为什么偏偏选择了腾讯WorkBuddy?核心原因在于它精准地解决了“落地难”和“集成贵”这两个痛点。与传统的OpenClaw等纯代码框架不同,WorkBuddy作为一款桌面智能体,天然具备本地文件操作权限。这意味着它可以直接读取授权文件夹内的配置文件,无需通过复杂的API中转即可获取本地数据,极大简化了数据源的接入流程。
更关键的是,WorkBuddy内置了实时联网搜索能力。对于情报日报而言,时效性就是生命线。它可以直接抓取厂商博客的最新更新和GitHub仓库的热度变化,而不需要你自己去维护一套脆弱的爬虫脚本。这种“搜索+本地处理”的组合拳,让它能够轻松支撑起“配置读取→搜索→生成→推送→部署”这样长的任务链。在选型对比中,虽然OpenClaw拥有更极致的代码可控性,但WorkBuddy原生支持企业微信对接且无需自建服务器,对于希望快速验证MVP(最小可行性产品)的团队来说,这种零部署门槛的优势几乎是无与伦比的。
三、核心Prompt配置设计详解
选型确定后,真正的核心在于如何通过配置文件“驯服”AI。在WorkBuddy中,我们将所有业务逻辑封装在 daily-brief-config.json 中,这份被戏称为“情报宪法”的文件直接决定了日报的质量下限。
首先是 核心过滤原则。我们在 core_filter 字段中明确界定:“所有信息必须明确影响企业数据平台的产品路线、架构设计、成本结构或运维效率,否则不予收录。”这一规则旨在剔除那些看似热闹但与数据基础设施无关的泛科技新闻。
其次是 排除规则。针对AI领域常见的噪音,我们在 exclusions 中列出了黑名单,包括“纯AI新闻:模型发布、benchmark等”、“财经媒体的二次报道”以及“无法验证的传闻和标题党内容”。注意:对于技术情报而言,去伪存真比追求数量更重要。
最后通过 厂商优先级 进行分层。Tier 1 包含 AWS, Google Cloud, Azure, Databricks 等头部云厂商及核心数据平台,确保高权重信源的覆盖度。通过这种精确的规则定义,AI不再是一个模糊的生成器,而是一个执行严格标准的过滤器,为后续的自动化部署奠定坚实基础。
四、系统架构与代码实现
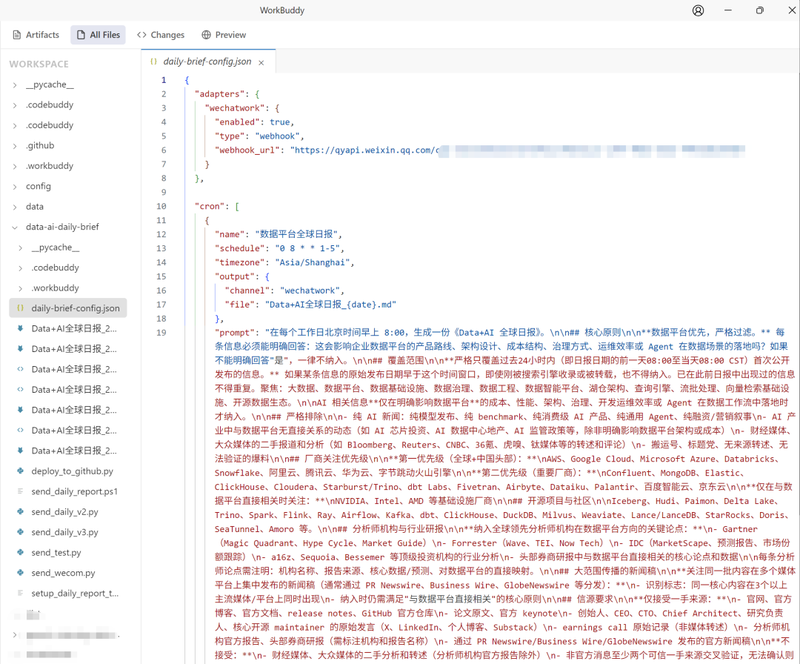
配置定义好“标准”后,剩下的工作就是让机器自动执行。整个系统的运行链路非常清晰:WorkBuddy读取JSON配置,执行全网搜索,生成Markdown报告,最后通过脚本分发至企业微信和GitHub Pages。为了确保部署环境的最小化依赖,两个核心Python脚本均未使用任何第三方库,完全基于标准库实现。
在摘要提取环节,extract_summary_from_md函数负责将长文精简。它并非简单截断,而是保留Markdown的标题和列表骨架,将内容严格限制在3850字符内,既保证信息密度,又适配企微卡片展示。文件上传则更具挑战,upload_file_to_wecom函数手工构建了multipart/form-data请求体。通过设置boundary并拼接二进制数据,我们绕过了requests库,直接调用urllib完成文件传输。这种“裸写”HTTP协议的方式虽然略显繁琐,但确保了在任何受限环境中都能稳定运行,真正实现了零依赖的自动化闭环。