本文解析华盛顿大学发布的FLEX-π模型,通过融合3D几何与物体语义特征,解决机器人操控中的泛化难题,展示其在真机实验中高达94.6%的成功率及部署优势。
近日,华盛顿大学联合艾伦人工智能研究所推出了名为FLEX-π的世界-动作模型。该模型创新性地融合了RGB视觉、3D点图几何及DINO物体语义特征,显著提升了机器人在复杂环境下的操控能力,在真机测试中展现出超越基线模型的卓越性能。
一、FLEX-π核心机制解析
FLEX-π 的核心突破在于重构了机器人感知世界的底层逻辑。传统世界-动作模型往往受限于二维视觉平面,难以捕捉物体的空间深度与具体语义属性,导致在复杂场景中泛化能力不足。该模型创新地将 RGB视觉、3D点图几何及DINO物体语义特征 嵌入统一的共享隐空间,使得模型不仅能“看见”像素,更能“理解”结构。
在技术架构上,FLEX-π 采用了冻结状态的 VAE 编码器来处理 RGB 图像与 3D 点图,并结合 DINOv3 构建物体中心特征。这种设计巧妙避开了重新训练视觉先验的高昂成本,直接复用了预训练模型的强大表征能力。更关键的是其灵活的推理机制:通过引入视觉流 Dropout 与跨模态约束,系统支持在推理时任意选择输入与输出子集。这意味着部署时可根据实际需求灵活调整模态组合,而无需新增任何传感器,也不增加推理延迟。这种“即插即用”的灵活性,为后续的高精度真机实验奠定了坚实的技术基础。
二、真机实验:高精度任务表现
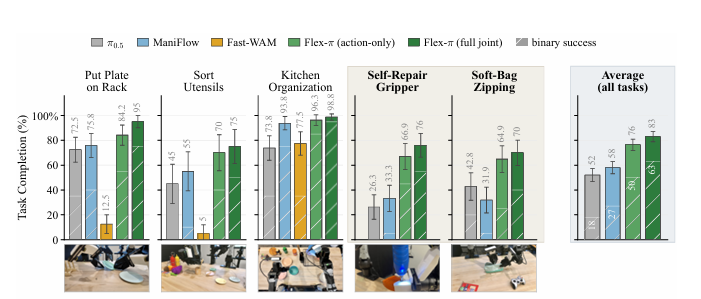
技术架构的灵活性最终需要落地到实际操控中接受检验。在真实的双臂YAM机器人平台上,FLEX-π 面临了五项涵盖不同难度梯度的高难度任务挑战,包括盘子上架、餐具分拣、厨房整理、自修末端夹爪以及软质笔袋拉链操作。这一系列测试旨在验证模型在复杂物理交互中的鲁棒性,特别是面对非刚性物体和精细末端调整时的表现。
实验数据直观展示了 FLEX-π 相对于 π0.5、Fast-WAM 等基线模型的显著优势。在常规的厨房整理任务中,全模态模式下的成功率比最强基线高出 5.0%。然而,随着任务难度提升,这种优势呈指数级扩大:在极具挑战性的自修末端夹爪任务中,FLEX-π 的表现超出了基线 42.7%;而在需要精细力控的软质笔袋拉链操作中,领先幅度也达到了 27.2%。这表明,当环境复杂度增加、对几何与语义融合的依赖加深时,FLEX-π 的多模态融合机制能更有效地抑制误差累积,确保持续的高精度操控。这种性能随难度提升而放大的特性,正是其解决长尾分布问题的核心体现,也为后续探讨其在分布外数据上的泛化效率提供了有力的实证支撑。
三、分布外泛化与数据效率
在真实场景中,机器人往往面对的是训练数据之外的“陌生”物体与杂乱背景。为了验证 FLEX-π 在这种分布外(Out-of-Distribution, OOD)条件下的鲁棒性,研究人员引入了从未见过的物体,并将视觉背景设置为极度混乱的状态,同时仅使用一半的示范数据重新训练模型。这一设置旨在模拟实际部署中数据稀缺且环境多变的极端情况。
测试结果显示,FLEX-π 对视觉分布偏移表现出极强的抗干扰能力。在仅用一半数据训练的情况下,全模态模式的性能下降幅度仅为 4.7%,而仅动作模式更是仅下降 4.1%。相比之下,基线模型的表现则大幅滑坡:ManiFlow 的性能骤降 26.7%,π0.5 在软质笔袋任务中的成功率也下滑了 25.6%。这表明 FLEX-π 的多模态融合机制有效降低了对海量特定数据的依赖,使其在数据效率与泛化能力之间取得了更优的平衡,为实际落地中的快速适应提供了可能。
四、推理速度与成功率权衡
在验证了模型对数据稀缺和分布偏移的鲁棒性后,我们还需要关注其在实际部署中的实时性能。为了全面评估 FLEX-π 在标准环境下的表现,研究团队采用了包含50项复杂操作任务的 RoboTwin 仿真基准作为测试平台。这一基准涵盖了多种精细操控场景,能够直观反映模型在推理速度与任务成功率之间的权衡能力。
测试数据显示,FLEX-π 在“仅动作模式”下展现了极高的效率与精度,其成功率达到了 94.6%。这一成绩不仅超越了当前最强的 VLA 基线模型 Qwen-RobotManip(93.9%),更证明了该模型在简化输入流后仍能保持卓越的操控稳定性。而在“全模态模式”下,FLEX-π 的优势更为明显,它成功击败了包括 Motu 以及最新发布的 LingBot-VA 2.0 在内的所有世界-动作模型(WAM)基线。这意味着 FLEX-π 并非以牺牲速度为代价换取准确率,而是在融合多模态信息的同时,依然维持了高效的推理节奏,为高实时性要求的工业或家庭服务场景提供了可靠的技术支撑。
五、模型局限性与未来展望
尽管 FLEX-π 在真机测试中交出了亮眼的成绩单,但在技术落地的最后一公里,仍存在一些不可忽视的工程挑战。多流模态的深度融合虽然提升了感知上限,但也显著增加了优化的复杂度。具体而言,模型在真实世界微调阶段需要较长的收敛周期,至少需经历10个Epoch才能达到稳定状态,这对算力资源和时间成本提出了更高要求。
此外,在“全模态联合生成”模式下,由于需同步处理RGB、3D点云及语义特征,其推理延迟略高于参数量相当的传统 VLA 模型。虽然这一延迟在多数服务场景中尚可接受,但在对毫秒级响应极度敏感的高动态交互任务中,仍需进一步优化。从长远来看,FLEX-π 的语义推理能力与预训练规模仍有提升空间。研究团队指出,未来需引入更大规模的机器人预训练数据,以拓宽模型的泛化边界,使其在面对未见过的物体和复杂非结构化环境时,依然能保持高精度的操控性能。