本文深度解析Meta新旗舰模型Muse Spark 1.3,涵盖其性能基准测试、API定价策略及开发者实测反馈。帮助AI从业者和开发者评估其作为高性价比推理与编程模型的落地价值。
9月3日,Meta正式发布新一代旗舰模型Muse Spark 1.3,并在Artificial Analysis榜单上反超刚发布的Gemini 3.8 Flash。这款模型以极低的调用成本和显著的编程能力跃升为卖点,究竟能否成为企业级应用的高性价比之选?
一、模型发布与榜单性能对比
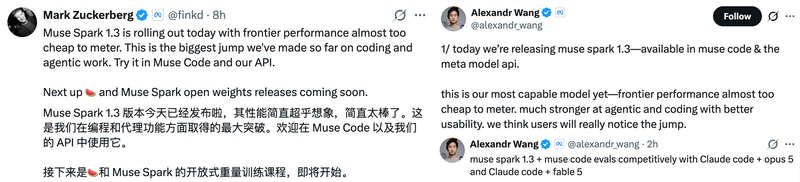
9月3日,Meta正式推出新一代旗舰模型Muse Spark 1.3。CEO扎克伯格在发布会上直言其性能表现“超乎想象”,这一评价迅速引发了行业内的广泛讨论。这款模型的核心定位非常清晰:旨在通过极致的性价比和显著的编程能力跃升,成为企业级应用中高性价比的推理与编程首选。
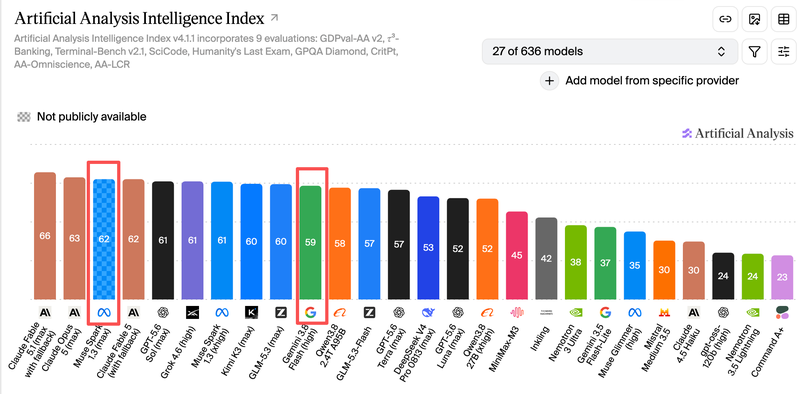
在备受关注的Artificial Analysis指数榜单上,Muse Spark 1.3取得了62分的成绩。这一分数使其紧紧咬住头部阵营,仅次于Claude Fable 5.1(66分)和Claude Opus 5(63分),确立了其“仅次于Claude”的市场地位。更具冲击力的是,在发布仅4小时后,该模型便反超了同期刚发布的谷歌Gemini 3.8 Flash(59分)。Meta首席AI官汪滔随后公开调侃Gemini,这一互动虽带有戏剧性色彩,但也侧面印证了新模型在基准测试上的强劲表现。对于开发者而言,这种在发布初期即展现出的竞争力,意味着在评估大模型选型时,Muse Spark 1.3已是一个不可忽视的高性能选项。
二、API定价策略与成本优势
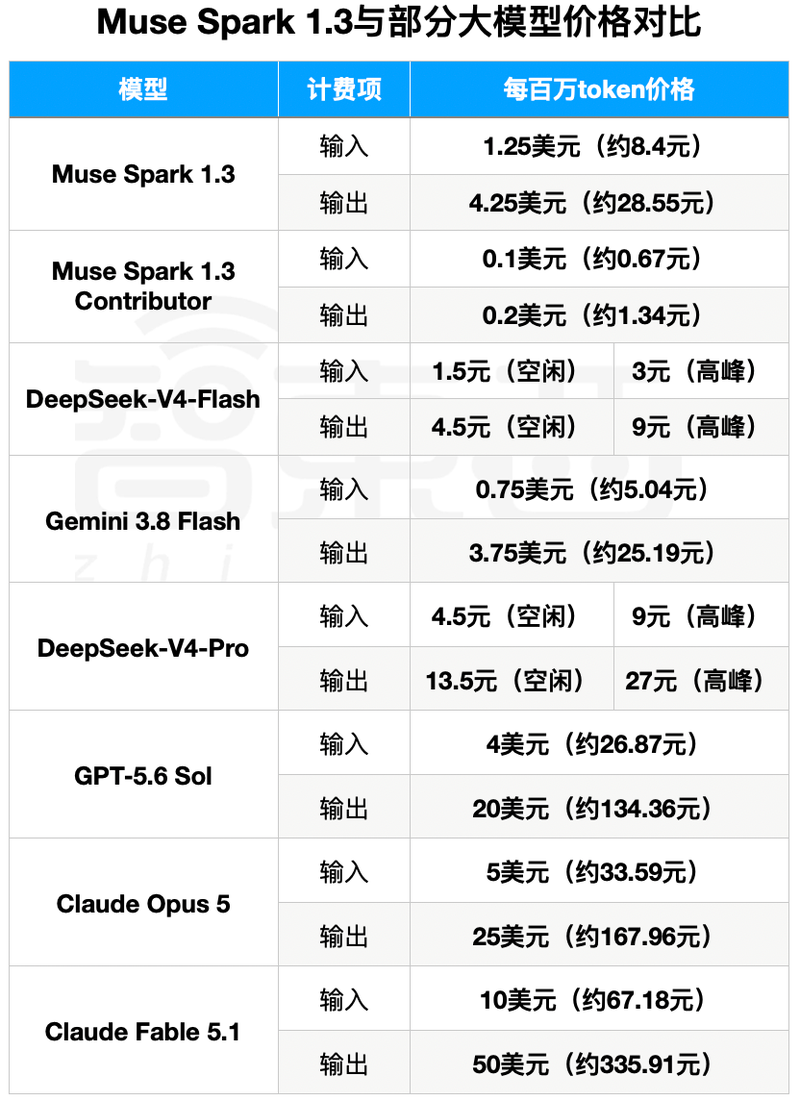
既然性能表现已经通过榜单验证,那么对于企业落地而言,成本往往是决定选型的关键变量。Muse Spark 1.3 在定价策略上采取了极具攻击性的姿态,试图以更低的价格门槛吸引开发者。
具体来看,其输入端(缓存未命中)的价格设定为每百万token 1.25美元(约合人民币8.4元),而缓存命中时的价格更是低至0.15美元(约合人民币1元)。输出端价格为每百万token 4.25美元(约合人民币28.55元)。横向对比来看,这一价格略高于同期的Gemini 3.8 Flash,但显著低于DeepSeek-V4-Pro在高峰期的调用费用。对于高频调用且具备良好缓存策略的应用场景,Muse Spark 1.3 的经济优势尤为明显。目前,该模型已在Muse Code与Meta Model API平台正式上线,开发者可立即接入测试,体验其在低成本下的稳定输出能力。
三、开发者实测:速度与效果
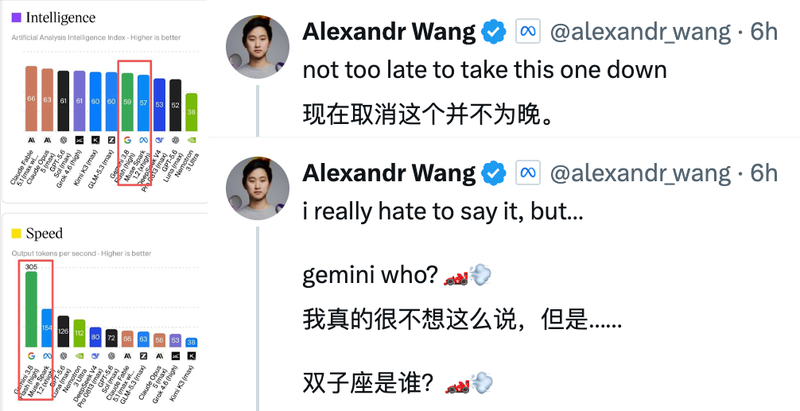
光有榜单数据和定价策略还不够,真实开发场景中的反馈才是检验模型成色的试金石。在社区近期流传的实测案例中,Muse Spark 1.3 的表现呈现出明显的“性价比突出但极限能力受限”的特征。
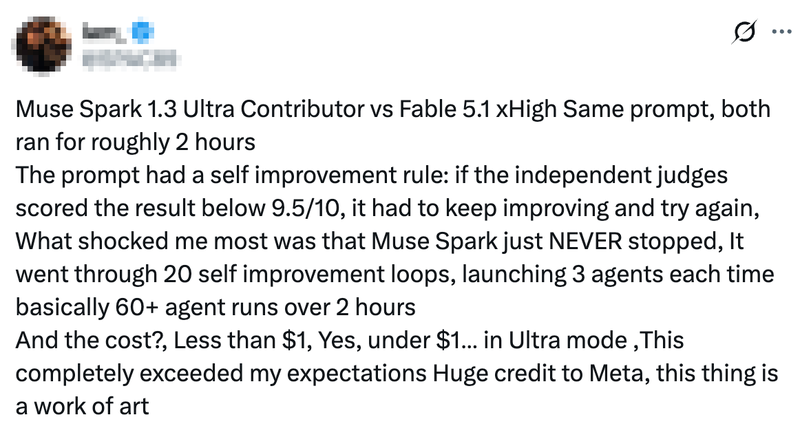
最引人注目的案例来自一位游戏开发者,他利用该模型生成了《我的世界》风格的建筑场景,整个调用成本仅消耗了10美分(约合人民币0.67元),响应速度极快。在3D模拟领域,对比从1.1到1.3的迭代,建筑结构的复杂度和空间逻辑有了显著提升,且总成本稳定在0.6美元左右。更令人惊讶的是其长任务处理能力,在开启Ultra模式下,模型连续运行2小时,执行了超过60次智能体任务,总花费不到1美元,展现出极强的稳定性。
当然,这种低成本背后并非没有代价。在MineBench等针对生成质量的深度测试中,Muse Spark 1.3 的输出精细度和逻辑连贯性距离顶尖前沿模型仍有可见差距,尤其在高精度渲染细节上略显粗糙。综合来看,其速度与成本优势目前与Qwen 3.8处于同一梯队,适合对成本敏感且追求快速迭代的开发场景,但在追求极致画质的项目中需权衡取舍。
四、长周期任务与编程能力优化
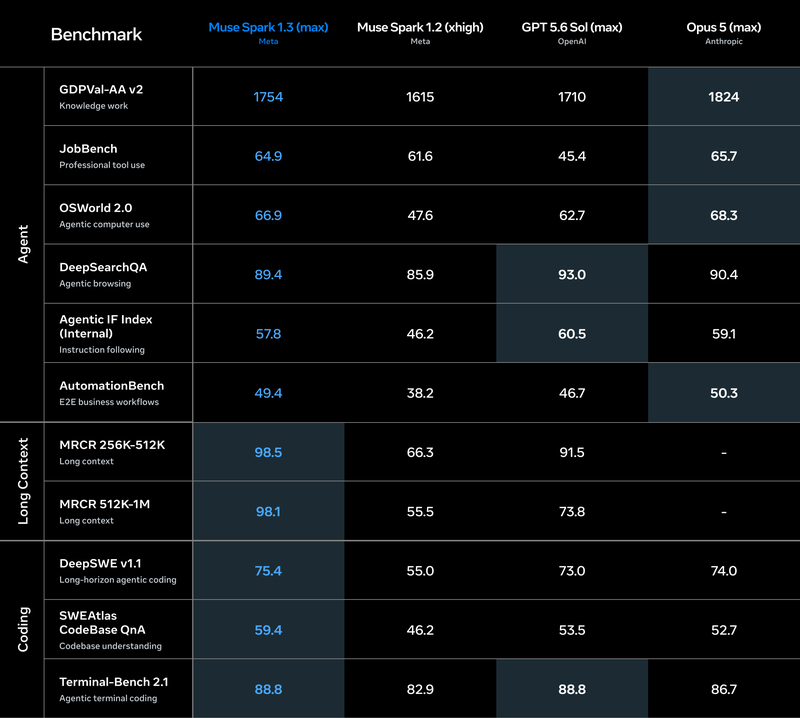
实测中的“性价比”并非仅源于低单价,更深层的原因在于Muse Spark 1.3在工程效率上的显著优化。Meta官方数据显示,相比1.2版本,该模型在解决同类编程任务时,工具调用次数减少了20%,同时Token消耗降低了25%。这种效率提升直接转化为开发成本的下降,使得模型在处理复杂逻辑时能更精准地命中目标,而非通过大量试探性调用来“撞”出答案。
这种优化在处理长周期任务时尤为关键。Muse Spark 1.3支持在单会话中并行处理多条工作流,并能自主构建上下文以修正方案中的逻辑漏洞。即便在信息杂乱、干扰因素多的上下文中,它也能准确匹配新输入提示至对应的任务分支,避免了传统模型容易出现的“上下文漂移”问题。在DeepSWE、OSWorld等模拟真实工程场景的基准测试中,这种稳定性使其成功反超部分前沿模型,展现出更强的鲁棒性。此外,新版本还增强了对抗鲁棒性,显著提升了抵御提示注入攻击的能力,为企业级应用的部署安全提供了更坚实的底层保障。