本文解析亮源新创开源的通用导航大脑LightNav-0,讲解其通过Real-Sim-Real路径实现数据规模化生产的方法,帮助开发者理解具身智能在多形态机器人上的零样本部署逻辑。
在具身智能落地应用中,机器人如何适应不同环境、任务乃至本体形态的变化,是核心挑战。亮源新创开源的LightNav-0模型,通过独特的数据引擎和三阶段后训练,实现了跨平台、跨场景的零样本导航能力,揭示了数据规模化生产在Physical AI中的关键价值。
一、数据引擎构建仿真训练场
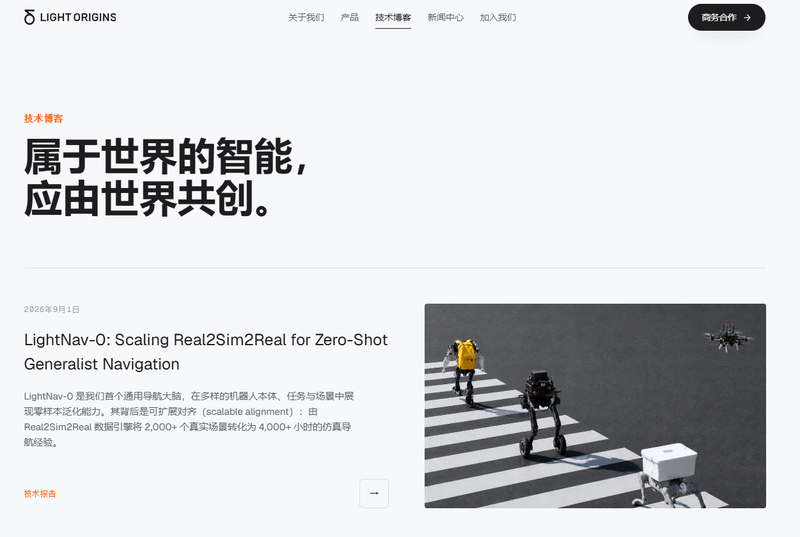
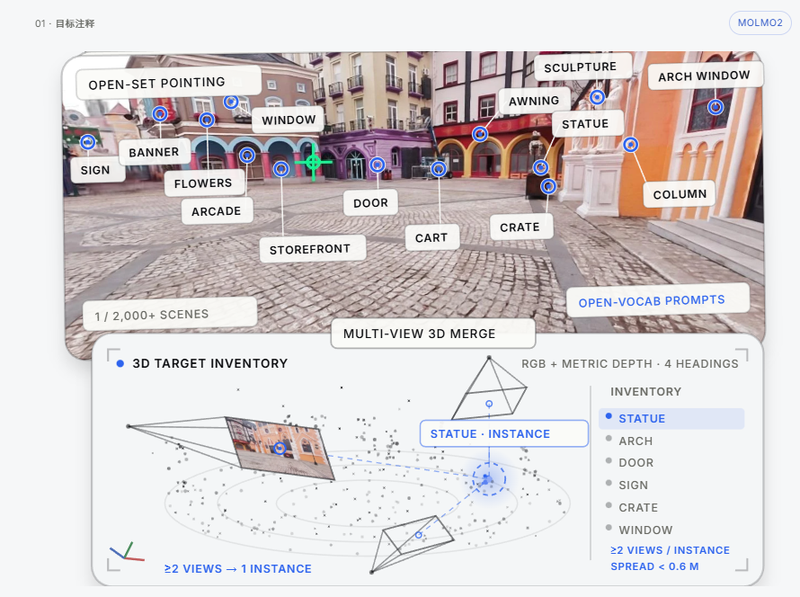
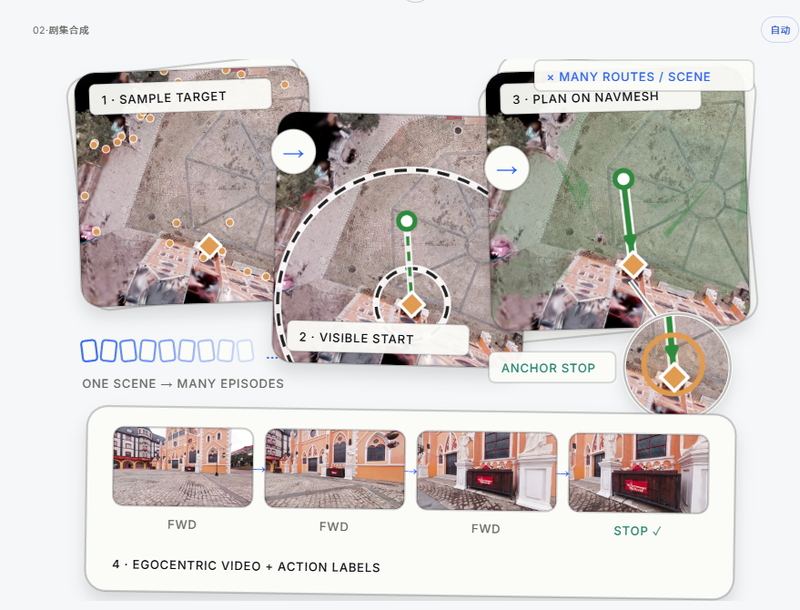
在具身智能的研发中,真实环境数据的获取往往受限于高昂的成本与不可控的变量,这直接制约了模型泛化能力的提升。LightNav-0 的核心突破在于构建了一套高效的数据引擎,将一次性采集的真实场景转化为可无限复用的数字资产。团队采集了2000多个真实室内外场景,并通过统一仿真接口接入虚拟环境,打破了物理世界的时空限制。
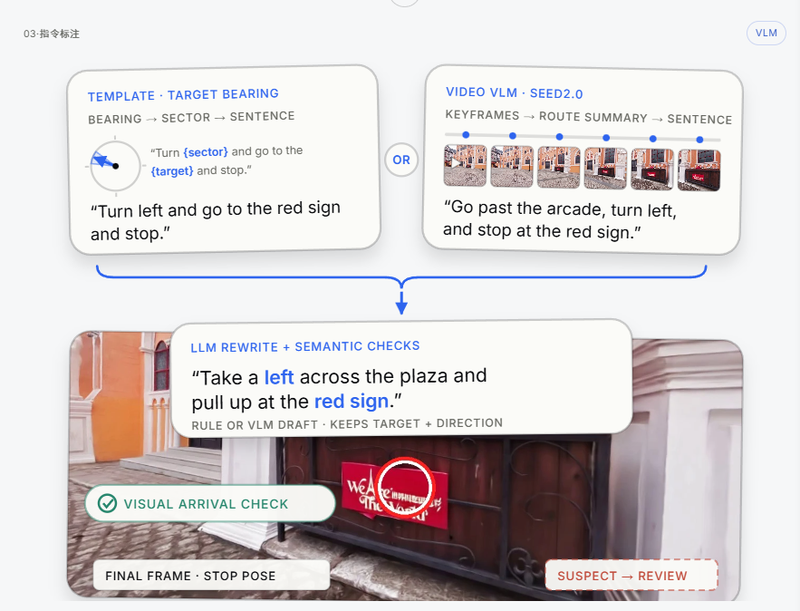
在仿真环境中,引擎通过随机变化相机高度和安装角度,模拟人形、四足、轮式等不同本体形态的视觉视角。这种多视角扰动不仅丰富了数据的多样性,更关键的是生成了视觉、语言、动作、空间位置四维度同步对齐的高质量数据记录。通过这种大规模的生产模式,LightNav-0 积累了超过4000小时的视觉-语言-动作对齐经验,形成了数据驱动模型、模型优化数据采样的正向循环,为后续的多模态对齐训练奠定了坚实基础。
二、三阶段后训练强化空间认知
拥有了海量且对齐的高质量数据,如何将其转化为模型的可迁移能力?LightNav-0 采用了精心设计的三阶段后训练策略,模拟人类从“看懂环境”到“学会行走”再到“试错修正”的认知过程。
第一阶段是ER中期训练。模型利用图像和视频数据建立初步的视觉语言空间理解能力,这是导航的基石——只有先“看懂”空间结构,后续的行为决策才有依据。在此基础上,第二阶段进入SFT监督微调。模型在之前积累的4000多小时多模态对齐数据上进行学习,通过大量标准答案的模仿,掌握不同场景下的标准导航行为,从而学会“走路”。然而,模仿学习往往难以覆盖所有长尾场景,因此第三阶段引入了RL强化学习。在仿真环境中,模型通过奖惩机制进行自主探索,从错误的轨迹中获取负反馈并自我纠偏。这一过程让模型不仅学会了“怎么走”,更学会了“为什么这么走”,最终获得具备鲁棒性的可迁移导航判断逻辑。
三、仿真评测与真机零样本验证
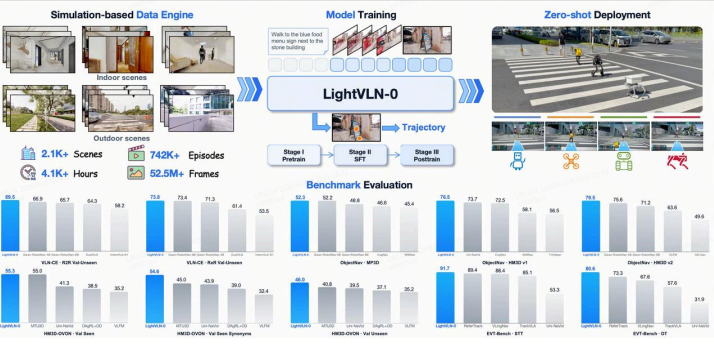
经过三阶段后训练的打磨,LightNav-0 的泛化能力终于迎来了终极考验:从虚拟仿真到真实世界的零样本部署。在仿真评测环节,该模型在包括VLN-CE、Matterport3D等在内的10项VLN基准测试中全部排名第一,展现了极强的空间推理与指令遵循能力。更为严苛的是,团队自研的INSIGHT-Bench基准涵盖了210个模型从未见过的场景和1097条复杂指令,LightNav-0 在此仍取得了最高成功率,证明了其并非过拟合于已知数据,而是真正掌握了通用的导航逻辑。
仿真领先只是起点,真机部署才是具身智能的核心指标。LightNav-0 无需针对特定本体重新训练,直接以零样本方式成功部署于人形、四足、飞行及轮式四种截然不同的机器人平台。无论是执行长指令跟随、开放词汇物体导航,还是目标追踪任务,各类形态的机器人都能准确响应并完成动作。这种跨平台、跨形态的即插即用能力,不仅验证了“导航大脑”架构的通用性,也为后续构建Real-Sim-Real闭环数据飞轮奠定了坚实基础。
四、Real-Sim-Real闭环价值解析
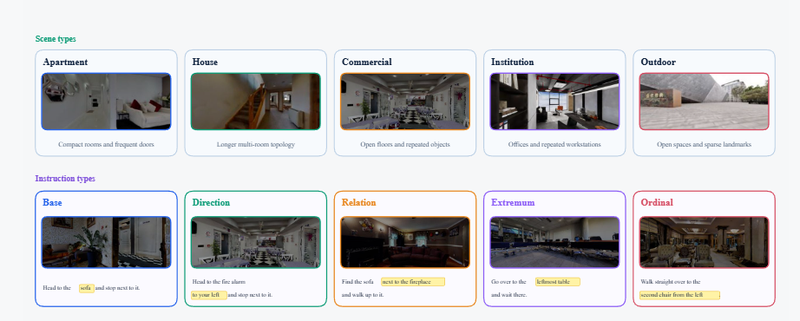
从仿真榜单的满分到真机的零样本落地,LightNav-0 不仅验证了模型的鲁棒性,更揭示了一个被低估的核心逻辑:在具身智能的深水区,真实场景定义数据质量的下限,而仿真环境则负责打破数据规模的天花板。这种Real-Sim-Real的闭环机制,精准地解决了行业长期存在的痛点——纯真实数据采集成本极高且难以覆盖长尾场景,而纯仿真数据又常因“现实差距”导致模型在真机上“水土不服”。LightNav-0通过双管齐下,兼顾了数据的“质”与“量”,成功突破了物理世界与虚拟世界之间的天然壁垒。
这也意味着,Physical AI竞争的下半场,焦点将从单纯的算法架构转向数据规模化生产的能力。谁能让数据飞轮转得更快、更贴近真实物理规律,谁就能掌握泛化能力的主动权。当然,目前的验证主要基于标准导航任务,后续团队计划开放更贴近真实使用场景的VLN评测体系,特别是针对异常恢复能力的考核,这将进一步检验“导航大脑”在复杂多变现实环境中的生存智慧。